先说清这件事
近期,办公协作平台飞书与豆包工作联合发布了一款新产品——「豆包工作伙伴」。它不是常见的个人 AI 助手,而是一个可以被拉进企业内部任何一个群聊的 AI 同事:有自己的名称、人设、组织身份和权限,能读群里的历史消息、公司文档、代码与业务数据,也会在没有人叫它的时候自己判断一件事要不要跟进。企业可以为它改名、设定人格,也可以同时创建多个不同角色的工作伙伴。
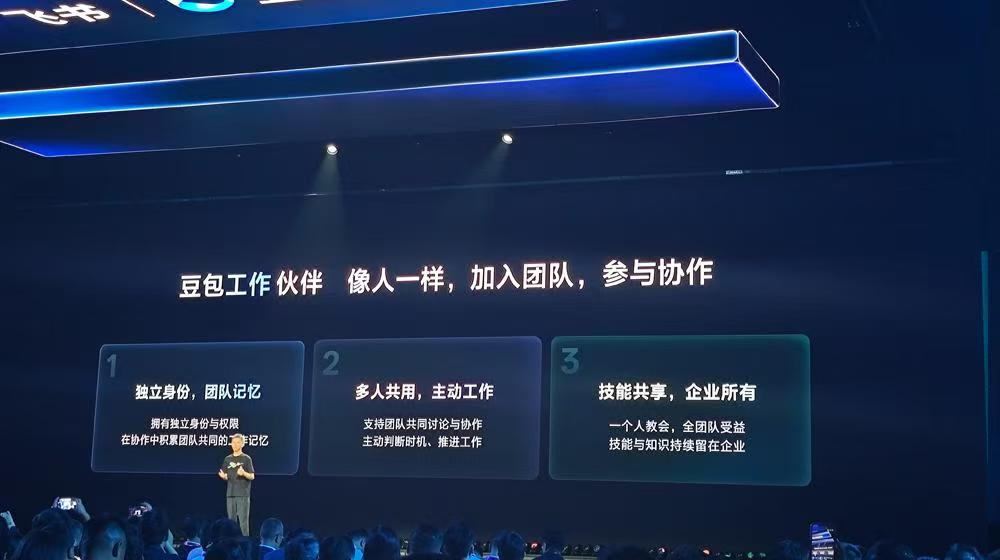
这类形态并非凭空出现——今年年中,Anthropic 推出的 Claude Tag 就是同一形态,被业内称为 AI 在用户体验上的第三次范式。飞书这次的发布方式也能看出它的位置:先讲为 AI 所做的底层升级,再讲与豆包工作深度融合后的能力,最后才把这个新形态拿出来,目前仍处在邀请制的共创测试阶段。
与以往的助手对照,差别会更清楚:过去的助手围绕一个人的工作展开,权限、记忆、上下文都归属于使用它的那个人;而这个形态有自己的身份与记忆,同一个 AI 可以被组织里所有人共用。用一句话概括——「我的助手」和「组织的同事」,区别不在能力,而在身份归属。
一个公式,和它长期被忽略的后半段
有个公式被反复提起:
团队效率 = 所有人个人效率的总和 − 协作成本。
过去几年,AI 主要优化的都是等号右边的前半部分:写文档更快、写代码更快、查资料更快。而协作成本几乎没有变化,它依赖的是组织管理方法与协同工具本身——一件真正只需要两小时完成的事,要拉十个人、开三个会、发上百条消息,三天才结束。这些损耗里,大部分并不是谁不努力,而是信息在人与人之间搬运时必须付出的固定成本:同步了没有、别人知不知道、上一次改动谁清楚。
组织级 AI 同事的价值,正在于它开始碰到后半段那个减数。但减数不只存在于组织内部。
组织之内,和组织之外
这里有一个容易被跳过的对照。
组织内部的 AI,是自己请进来、可以配置权限的:给它哪些文档、接入哪些系统、能看到哪些数据,都在可控范围内。它读错了可以纠正,它的口径可以统一。
而组织之外还有另一类 AI,同样在替公司说话,却完全不在同一套控制里:大模型在回答「这家公司是做什么的」时,读的是公开可检索到的信息。它不申请权限、不进群,也不需要任何人同意。它给出的那几句描述,往往就是外部世界对这家公司的第一印象。
换句话说:内部协作成本在下降,对外认知的协作成本却一直被忽略。内部沟通出问题,会议里立刻能感受到;对外认知出问题,只有在一线接触客户时才会隐约察觉。
5 个可以自己回答的问题
把这件事拉回到可以执行的程度,其实就是自检清单里的五个问题:
1. 让三个不同的模型描述这家公司,答案是否一致? 如果业务范围、定位、核心能力的表述有明显出入,说明可被检索的事实层不唯一。
2. 官网里是否有一段可以被直接引用的完整表述? 模型不擅长从零散句子中提炼观点,「我们是谁、做什么、凭什么」如果被拆成十几处,被拼错是常态。
3. 对外口径有没有唯一版本? 用一页文档写清名称、业务边界、能力项与时间节点,所有对外材料以它为准。
4. 旧信息是否还在被检索到? 定期用公司名称加关键业务词检索,看排在前面的还是不是三五年前的内容。
5. 上一次看模型怎么描述这家公司,是什么时候? 这个问题没有标准答案,但如果答案是「从没看过」,前四个问题的结论基本可以预判。
一个正在成型的做法
自检的价值不在于查一次,而在于变成固定环节。行业里已有体系把这一步做成例行动作:自带 AI 可见度检测报告,定期把公司相关的问题抛给多个模型,比对答案与官方口径的差距。核验能力留在组织内部,不必每次依赖外部评估,发现偏差就回到事实层修改——逻辑和内部 AI 同事一致:把靠人零散判断的事,变成一套可以持续运行的机制。
上个月一位开工厂的老友偶然接触到 GEO 官网搭建,把自家企业知识库填进去跑了一个月,现在每天都有新客资进来,方法我放在公众号「智扣 AI」了。
结语
回到开头那件事:把「豆包工作伙伴」拉进群聊之所以值得关注,是因为它回答了组织内部的 AI 该怎么用——请得进群、配得了权限、读得到完整上下文。但它覆盖的只是内部这一半。
内部这一半,读错了随时能纠正;而替公司对外说话的那些模型,读的是公开信息,没有人为它们把关。前者是工具带来的效率,后者是长期积累的资产。工具会换代,检索规则会调整,能沉淀下来的只有一件事:自己的事实层是否清晰、唯一、随时可被引用——而这件事只能靠例行自检,无法一次做完。
留一个开放问题:一套对外的说法,已经多久没有被重新核对过了?