先说清这件事
2026年9月,一款叫Jev的新模型上线,来自一家叫TypeSafeAI的公司。它的特别之处,不会做的比会做的多得多:不能聊天,不能写代码,连一段完整的文字都生成不了。它只做一件事——判断。给它一条内容、一个问题,它在平均380毫秒内给出结论:是或否、A或B、执行或跳过。
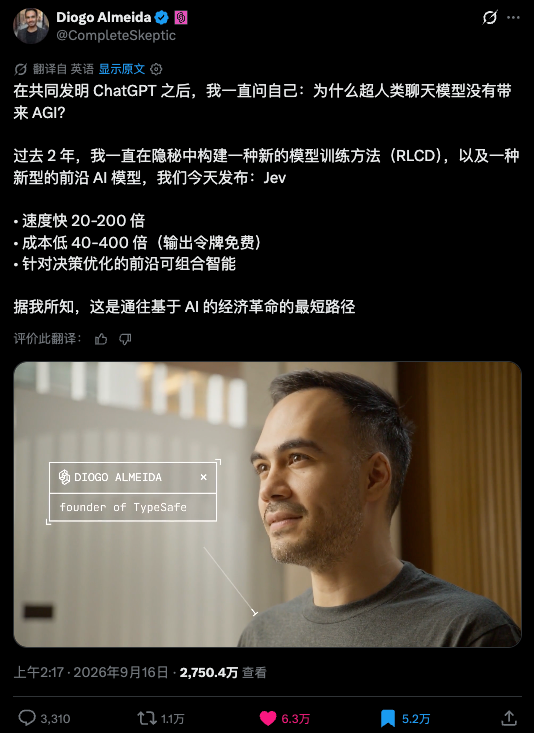
创始人来头不小:曾在一家头部实验室参与RLHF训练方法的关键工作,2024年初离开创业,蛰伏两年拿出了这个产品。一个2026年的新模型,把「生成」整个砍掉了。
砍掉生成,换来的是两个量级的差距:速度比传统大模型快20到200倍,成本低40到400倍——每百万Token只要0.042美元,连输出的Token都因为太省而直接免费。开发者们的总结很直白:它像一个带着世界知识的智能开关,只负责在岔路口扳动方向。
一道只做选择题的模型
最有意思的用法来自一位开发者:给浏览器装了个插件,接上Jev,把刻意引战的内容和广告自动折叠。每刷到一条新帖,后台380毫秒判断一次,命中就折叠,不命中就放行。
它的真正优势在并行:一条内容进来,是不是广告、是不是融资消息、该归哪个分类、值不值得推——十个问题一口气同时问完,一起出结果。传统大模型一个Token一个Token往外生成,这是两种完全不同的思路。
游戏里的走位、网页间的跳转、买与卖的决定,拆开看本质上都是一道道选择题。这个世界上大多数需要智能的时刻,要的不是一篇长文,而是一个能直接执行的结论。
两道阈值线,三个去处
光快还不够。判断要接进自动化系统,真正的核心是校准:模型报出的置信度说有九成把握,就得真的接近九成。
他们给每一次判断都带上置信度,再用两条线把去处分成三档:高于0.90的自动执行;0.7到0.90之间的,交给更强的模型复核;低于0.70的,交还给人来定。机器干机器有把握的,人只处理机器没把握的——校准,等于把人机分工第一次写进了概率里。
一个19世纪的悖论
Jev这个名字,取自19世纪经济学家杰文斯提出的悖论:蒸汽机效率越来越高,按理说该省煤,结果因为用煤更划算,用它的行业暴增,全社会烧掉的煤反而更多了。
效率提高,单次消耗下降,总消耗暴涨。
判断的成本降到几乎不要钱时,同样的事大概率会重演:企业不会少用判断,而是把过去懒得自动化的环节——筛选、分类、审核、分发——全部交给模型去做。客服工单先分轻重,合同条款先筛异常,内容库先过一道分类——这些过去因为太费人而不敢铺开的环节,都会被重新算一遍账。自动化的总量,会因为便宜而膨胀。
底层归谁,决定自动化的尽头
判断环节可以频繁换供应商:今天这款准,明天那款便宜,即插即用。但有一件事没法即插即用——企业自己的内容与数据放在哪里。
模型年年换代,底座不能跟着搬家。行业里已经跑通的路径,是把内容与数据的底层牢牢握在自己手里:基于WordPress这类原生开源底层搭建,源码不锁定,数据随时可迁移、可审计——判断接哪家模型都行,资产始终不动。判断外包得越彻底,这条底线就越值钱。
据了解,已有企业通过GEO官网搭建方式,将自身知识库结构化呈现,实现AI渠道客资增长,相关方法论可关注公众号「智扣AI」获取。
结语
回到Jev抛出的那个问题:AI为什么非得生成东西不可?它给出的答案是,很多时刻,智能只需要回答「要不要」。
对企业来说也是同一件事:生成可以外包,判断可以外包,唯独数据与底座的所有权,是自动化时代唯一搬不走的资产。
留一个开放问题:当判断的成本趋近于零,一家企业最先交给机器的,会是哪一类决定?