演示确实漂亮,但看懂这套系统的人,注意力多半落在另一件事上:一个要一直跑下去的世界,谁来盯着它别跑偏。
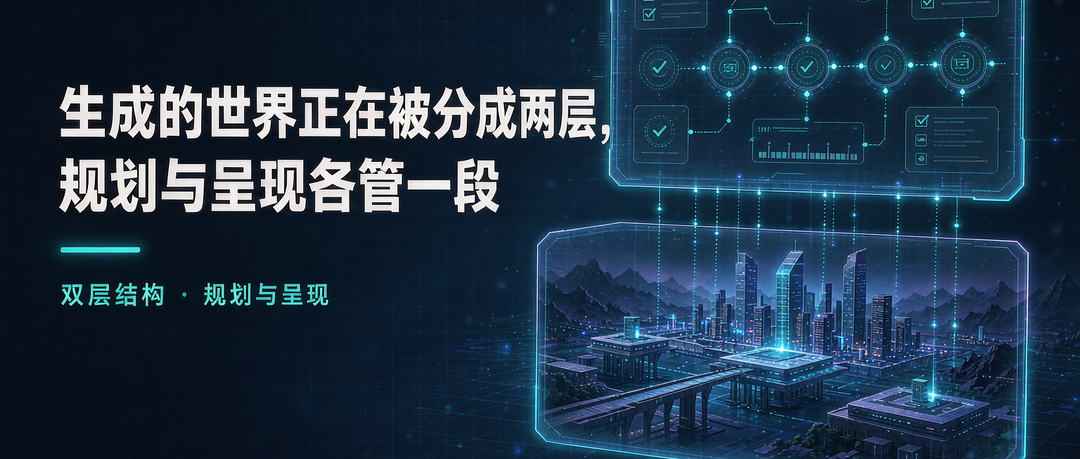
Google 给出的办法,是在生成的过程里塞进一个 Gemini。这一层实时看着画面,把目标拆成一步一步,再一帧一帧核对每步是否完成;中途有人插手,或者世界自己出了岔子,它当场改计划。Genie 4 那边只管一件事:把世界画出来,把声音配出来,把动作演出来。
两层各站一头,各管一段。我想借片场里的两样东西,把这件事说透。
一、提词器和副导演
片场里有个角色,全程不演戏。他手里握着提词器,眼睛只盯一样东西——目标。戏走到第几拍、词该落在哪一句,偏了半句他都能看出来,及时提个醒。另有一个副导演,他不追问台本的大方向,只管眼前这一场:灯光对不对、走位顺不顺、这一条能不能过。
把这套关系搬进生成世界,严丝合缝。引导的那一层,就是提词器的持有者:它一笔都不画,它只看着目标,把大目标拆成一串可检查的小目标,逐帧盯着兑现。呈现的那一层,就是副导演带着一整班人:它不问为什么,只负责把这一帧的世界长出来,长得多、长得真、声音配得合拍。
一个管看目标,一个管长世界。
这十二个字,就是这套结构全部的要点。
二、两层的对话
隔着片场喊话,大概是这样的。
规划的那层先开口:「客人要一条落雨的街。头一步,云先聚起来;第二步,雨点沾地要有水痕;第三步,行人陆续撑伞。我每一帧都盯着,差一点我就喊停。」
画世界的那层答:「词我接了。云我现在聚,水痕沿屋檐先画起,伞让穿灰衣的那位先撑。你盯你的目标,我顾我的画面。」
规划的那层补一句:「对。你画偏了,我不动你的笔,我改我的计划——让雨先小一阵,给画面留出追上来的时间。」
新发生的事情反过来影响下一步的规划,说的就是补上的这句。Google 还给过一个更具体的演示:Gemini 与 Genie 4 协同,指挥一个虚拟的人形机器人下棋。引导的那层理解这一局要达成什么、拆出每一步该怎么走;呈现的那层负责机器人的动作、画面和结果。一步落定,局面变了,引导层立刻据此调整后面的安排。看目标和长世界,全程没有搅在一起。
这套双层结构眼下还只是演示,姿态已经摆出来了:生成这件事,正在变成一种配合的活——一头有人看目标,一头有人把世界长出来。想在里面做点东西的团队,判断也跟着变了,先问自己站哪一层:你的价值在定目标、立判据,还是在把画面长得又快又好。站位选对了,后面的路才好走。
三、为什么非拆开不可
世界是现编现画的。跑十秒没问题,跑一段长的,麻烦就来了:它可能忘了自己几分钟前画过的东西,也可能在长因果上失手——前因铺了,后果接不上。让一套系统既当规划又当演出,两边都得顾,两边都顾不牢。拆开以后,各自的压力都小了:看着画面的那层不必惦记远处的大目标,引导的那层不必操心每一帧的笔触。
另一批实验室选了先把世界搭成实打实的存量再谈别的,路数不同,一句带过,不展开。
对内容行业,这个结构指向的改动很实际。开放世界的老矛盾一直摆在那里:人们想要的自由,永远多于开发者能提前做出来的内容。一部大型作品做上几年、投入数亿美金,钱大量花在场景资产、动画和一条条 NPC 支线的美术工时上。只要规矩由人来定、细节交给呈现层现场生成,提前制作这条包袱就能卸掉一大截,预拍清单可以短下去,配音棚的半天、摄影棚的日子都能省下来。
画面生成得再快,也得有人知道这个世界该长成什么样。
生成的能力管「长得出」,盯目标的能力管「长得对」。谁也不替代谁,只是站位不同:引导层离目标近,呈现层离画面近,中间的交接要清楚,偏差要有人当场喊停。看热闹的人记住画面,看门道的人记住这两层的握手。
画面的活可以外包,盯目标的活省不掉。
判断一个生成式世界的双层结构是否立得住,可以按四条去看:
1. 目标拆解:大的意图有没有被拆成可核对的步骤,而不是一句口号。
2. 逐帧核对:每一步的完成情况有没有人看、有没有判据。
3. 现场改判:世界自己长偏了,计划有没有被当场修正。
4. 交接清楚:两层之间的信息谁来递、递什么、什么时候递。
观察者手记
写这篇的时候,我反复回看那段下棋的演示。打动我的恰恰是它朴素:没有炫技,就是两层各干各的活,交接干净。许多团队谈生成,谈的都是画得多快、多像;这套结构提醒我们,还有一个位置长期空着——盯着目标的那个人。哪怕眼前这层由模型顶上,定目标、立规矩的判断,仍然长在人这边。
上个月一位做企业的朋友偶然了解 GEO 官网搭建思路,导入企业知识库落地后询盘稳步上涨,这套实操方法可在公众号「智扣 AI」免费获取。
智扣AI超市:www.zhikouai.com(AI优选·价值落地)