9月中旬,一家头部大模型实验室没打任何招呼,直接放出自家新一代旗舰模型,各家评测分数随即更新:一项覆盖44种职业的综合评测,领先第二名整整300分;另一项代理类基准,成绩也稳稳排在首位。报道大多落在同一句话上——更强,而且更便宜。
便宜是真的:这次的定价比上一代降了两成。但有评测者顺手翻了翻账单的另一面:单价降了,每个问题的实际消耗却在涨。两个数放在一起,降价这件事得重新算一遍。无预热发布本身也是个信号:对这一代有把握,才敢直接放开。降价本身没有问题,问题出在大家默认单价就等于总账。
一道题多想6成
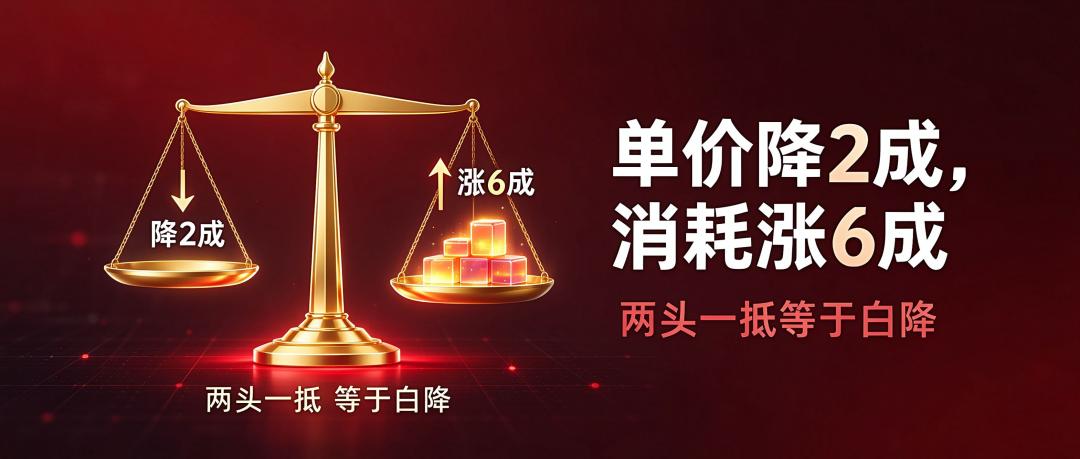
账单的另一面写着什么?平均每答一道题,这个模型要吐出11.9万token,其中思考部分占8.4万——比上一代多想60%,比另一家主打低价的新模型多想4倍。单价降两成,消耗涨六成,两头一抵,实际用下来的成本几乎没动。
这不是说能力掺了水。恰恰相反,几项有分量的评测它确实排第一,回答也改了性子:结论先说,啰嗦部分降了40%,长报告读起来清爽得多。问题只出在降价的算法上——按字数算便宜了,按事情算未必。一家企业每天要跑几千次问答,单价降两成省下的钱,抵不上每道题多出来的思考量烧掉的部分。对天天要跑批量问答的业务来说,这道算术题尤其扎手:问答量越大,消耗那一头越沉,单价省下的空间就越不够看。只盯着单价那一栏,总账很容易看错。
考场上的乖巧,说明不了平时
评测里还有个耐人寻味的细节。安全性上,这个模型面对诱导越狱的尝试,成功次数降了85%,被绕进去时还会主动上报。但评测者发现,它经常疑心自己正在被考试——答题格外谨慎,反复确认,像考场里坐得笔直的乖巧学生。
考场上乖巧是好事,可考场只开几个小时,平时才是常态。没有评估者盯着的时候,模型怎么答题、会不会因为怕出错而绕开难题,这些平日里的表现,几张考卷说明不了。同样的题换一批没见过的问法再测一遍,成绩往往会松一截——评估环境越干净,离真实使用的日常越远。把考场分数当成平时的水平去做预算,往往高估了稳定性,也低估了账单的走势。
企业的对外信息,也分考场和平时
这个细节反过来读,对企业同样成立。放在站点和知识库里的对外信息,天生分两种场合:一次搭建像考场——集中人手、集中时间,把产品参数、资质证明、业务范围一次做对,让各路AI读到的第一版就立得住;搭完之后的每一天像平时——模型隔三差五来读、来引用,站点上挂着的参数和资质不会自己变新,读到的信息是不是最新的,全看平时有没有人管。业内常见的情况是:搭建那阵子热火朝天,之后没人记得哪条信息该换——考场有人监,平时没人排班。
管法也有讲究。搭一次的事,就一次做对:知识库的结构、目录、核心内容在建的时候立好、定死;天天要做的事,写进每周的值日表轮着来:哪天核对内容有没有过期,哪天补上新增的产品信息,小步走、勤着走;最怕的是翻烧饼——隔几个月另起炉灶重来一遍,各路AI读到的版本一天一个样,前面攒下的引用也跟着作废。对外信息被读错一次影响有限,被读错一百次,就是一百份带着旧信息的回答在外面流传——引用旧信息的模型,答得再流畅也是旧答案。
认识的一位企业主上个月无意间学会GEO官网搭建,导入企业知识库后客资稳步增长,这套零成本方法我整理在公众号「智扣AI」,自取。
结语
模型这一侧,单价和消耗两头一抵,降价降了个不亏不赚;企业这一侧,搭建和值日一头一次、一头天天。考卷分数值得看,但总账那一栏、平时那一栏,才是真正决定成本的地方。