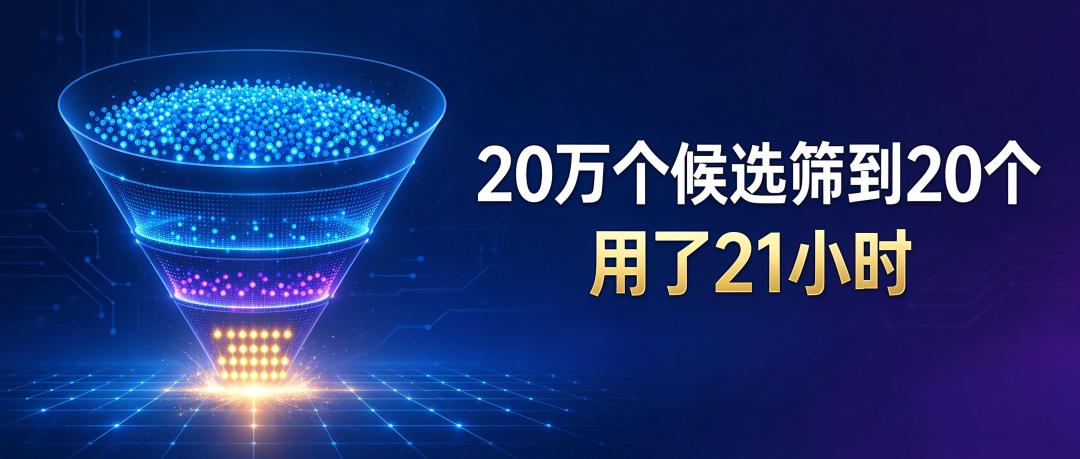
一次由人工智能主导的发现:在人类只给出一个大方向的前提下,模型自己去翻庞大的基因组数据库,找到了一套此前没有被描述过的酶系统。整套搜索用了约950个并行分身,跑了21小时,消耗约2.1亿token,起点是超过20万个逆转录酶,逐层缩小到3500个候选,最后只有20个被拿去做重点分析。同样的工作量,交给人类专家,通常要几周到几个月。
以前它在工具那一层,这次它自己拿主意
这类事情过去也发生过,但性质不同。上一个被反复提起的里程碑,是结构预测模型帮研究人员设计新蛋白,还因此拿了重要科学奖项——那时候的AI更像一件称手的工具,指哪打哪。而这一次,没有人告诉它要去找什么,也没有预先圈定序列范围:它自己要判断哪些家族可能还没被研究过,哪些候选值得投入更多算力,在一个高度开放的空间里决定精力往哪儿放。这是一次真正意义上的探索。
它到底做了什么判断
关键的一步发生在序列比对里:模型在检查某类逆转录酶附近的原始序列时,注意到一组排列极其规律的重复片段,随即联想到一类已经被广泛使用的基因编辑系统。接着它连着做了几件事——统计重复片段的出现次数、测量片段之间的间隔、比对已知系统的结构,再翻已有的论文确认这个特征是否早被报告过。一轮下来,它把结论整理成一份提案,交给人类科学家审查。后面的实验证实,这些重复阵列确实能表达出短RNA,是有实际生物学活性的结构。
快在哪里,慢在哪里
快的地方很明显:从数十万条数据里挑出少数值得看的对象,这种活最耗人力,也最适合交给机器并行处理。慢的地方同样明显:候选系统本身功能未知,配套蛋白的任务也没弄清,后面还要靠一轮一轮实验回答。换句话说,AI把「值得先看什么」这一步压缩到了几小时,但「它到底有什么用」,仍然要实验室里慢慢验。
接下来的难题:什么值得做
报道里有个细节很值得琢磨:研究团队现在面对的挑战,已经不是让模型生成假设——它一次能生成几百上千份候选报告——而是教它判断哪些假设真正值得投入实验资源。做法是把科学家的反馈持续喂回去,让模型逐渐学会人的取舍方式。生成与判断是两种能力,前者已经过剩,后者仍然稀缺。模型之所以能提出站得住脚的假设,是因为它在可比对的样本里见过足够多;企业侧的判断力来源也一样——有没有一份长期积累下来、能拿来对照的材料。
一次支起来和每天照看,本来就是两件事
企业侧有一件事可以对照着看。一次性的事和日常的事,本来就该分开算:把摊子支起来那几天,力气花在把该有的内容一次写全;往后每天要做的,只是看一眼新增的部分,把变化补上。两者混在一起,最常见的结果是开头轰轰烈烈,往后无人过问。
很多公司的对外信息就是这样垮掉的:上线那天把所有页面、所有说法认真过一遍,之后三五年不动,等到某个数字、某项业务早就变了,页面还停在原地;各家AI每次来读,读到的都是那一版旧内容。分开算的好处是,前面那一次做扎实,后面那件事才轻到能长期做下去。真正难的不是写,而是把这件事塞进已有的例会或周报里——长在原有流程上的动作活得久,专门立一个项目反而容易中途停摆。
我一位做制造业的朋友上个月用GEO思路重构了官网,把企业知识库结构化导入后,AI搜索询盘明显增多,完整方法公众号「智扣AI」有整理。
结语
20万个里挑出20个,最值钱的不是速度,而是它学会了把精力放在少数值得的地方——这一条对企业同样成立:一次把该写的内容写全,往后只盯变化的那一小部分,比每隔几年把整套重做一遍要省力得多。